數位壓力錶 × MySQL × API × 數位孿生:IT/OT 整合與工業物聯網架構完整指南
從現場一支數位壓力錶的 4–20mA、RS485 Modbus 或藍芽訊號出發,如何一路走到 MySQL 資料庫、REST API、儀表板,最後成為數位孿生模型裡一個「會說話」的資產?本文以昶特 ATLANTIS 31 年儀表製造經驗為基礎,替工廠工程師、系統整合商與 IT 團隊拆解整條資料鏈。
先講清楚分工:昶特 ATLANTIS 提供的是現場端的數位壓力錶、壓力傳送器、液位與溫度儀表,以及標準的類比與數位輸出介面。MySQL 資料庫、API 服務、雲端或內部平台與數位孿生模型,由客戶自己的 IT 團隊或系統整合商建置。本文的目的,是讓兩邊的人用同一套語言談需求、少走彎路,而不是宣稱昶特代為提供雲端整合服務。
本文目錄
- 前言:為什麼數位壓力錶會成為 IT/OT 整合的起點
- 第 1 章:整體架構——從現場儀表到數位孿生的五層模型
- 第 2 章:OT 端——訊號、通訊介面與量測資料品質
- 第 3 章:MySQL 資料層——資料表設計、寫入策略與保存期限
- 第 4 章:API 層——讀取、寫入、告警與權限設計
- 第 5 章:數位孿生——把壓力資料變成可推演的資產模型
- 第 6 章:昶特 ATLANTIS 產品與三層導入配置
- 第 7 章:情境推演與效益評估方法
- 第 8 章:資安、導入時程與驗收清單
- 第 9 章:20 個常見問題 FAQ
- 第 10 章:延伸閱讀與詢價
前言:為什麼數位壓力錶會成為 IT/OT 整合的起點
在多數工廠裡,壓力是最普遍、最便宜、也最容易被忽略的製程變數。冷卻水迴路、壓縮空氣、液壓系統、蒸汽管線、潔淨室壓差,幾乎每一個公用系統都有壓力點,而且很多壓力點到今天仍然是機械指針錶,靠人員巡檢、用眼睛讀數、寫在紙本點檢表上。這種做法在設備單純、人力充足的年代可以運作,但在今天會遇到三個越來越明顯的問題。
第一個問題是資料沒有時間軸。紙本點檢表一天記錄兩三次,等於把一天 86,400 秒的壓力變化壓縮成兩三個點。冷卻水泵浦在凌晨三點出現的短暫壓力下探、壓縮空氣在換班尖峰時的壓降、過濾器壓差在週末悄悄攀升,這些事件都不會出現在人工讀數裡。等到產線異常、品質異常,工程師回頭找證據,才發現沒有任何資料可以佐證。
第二個問題是資料沒辦法被機器使用。就算現場有智慧型儀表,如果訊號只進了單機的 PLC 或顯示器,沒有進入統一的資料庫,後續的趨勢分析、跨設備比較、預測性維護、數位孿生模型,全部都缺少輸入。IT 部門想做資料分析,卻不知道 OT 端有哪些點位、單位是什麼、校正日期是哪天;OT 部門想導入雲端或 AI,卻不確定資料要用什麼格式交給 IT。
第三個問題是責任界線模糊。當一個壓力讀值在儀表板上出現異常,到底是製程真的出問題、儀表漂移、訊號線受干擾、閘道器掉封包,還是資料庫寫入延遲?沒有一套清楚的資料品質標記與稽核欄位,這類問題只能靠人跑現場。時間一久,IT 與 OT 互相推責,整合專案也就難以延續。
因此,把數位壓力錶接進 MySQL 與 API,並進一步映射到數位孿生,不只是「加一個網頁看讀值」的小專案。它真正在處理的,是量測資料如何被可靠地採集、被正確地解讀、被安全地分享、被持續地使用。選擇壓力錶作為起點的好處是,量測原理成熟、介面標準、單點成本低,可以用最小的風險驗證整條資料鏈,再逐步擴展到溫度、液位、流量與設備狀態。
本文適合誰閱讀
- 工廠的設備、機電、製程與廠務工程師:想知道現場儀表要怎麼規劃,才能讓 IT 好接。
- 系統整合商與自動化工程師:需要一份能與客戶 IT 溝通的資料鏈設計參考。
- IT 與資料團隊:需要理解 OT 端訊號特性、資料品質問題與資安邊界。
- 採購與管理決策者:想評估「從機械錶升級到數位化」的範圍、分工與階段投入。
本文的範圍與誠實聲明
本文會提供具體的資料表設計、API 範例與數位孿生資料模型,讓您可以直接拿去做原型。這些範例屬於通用工程實務,目的在於說明概念與設計取捨,實際專案仍需依您的網路架構、資安政策、資料量與既有系統調整。昶特 ATLANTIS 不提供雲端平台、AWS 或資料庫整合服務,客戶需自行將儀表輸出接入自己的系統;我們能做的是在儀表選型、輸出介面、量程與環境適用性上,提供清楚的規格與建議,並協助您把需求講清楚。
本文提到的產品規格以昶特官網產品目錄為準,實際型號、量程、輸出選項與認證請以最新規格書與報價內容確認。昶特產品採報價制,本文不列任何價格。
第 1 章:整體架構——從現場儀表到數位孿生的五層模型
在討論 MySQL 表怎麼設計、API 怎麼寫之前,先把整條資料鏈切成清楚的層次。每一層只負責一件事,層與層之間用明確的介面溝通,這樣出問題時才知道往哪一層查,擴充時也不會牽一髮動全身。本文採用五層模型:儀表層、邊緣層、傳輸層、資料與 API 層、應用與孿生層。
1.1 五層模型總覽
[ 儀表層 ]  數位壓力錶 / 壓力傳送器 / 溫度 / 液位
     │  4–20mA · 0–10V · RS485 Modbus RTU · HART · 藍芽
     ▼
[ 邊緣層 ]  PLC / 遠端 I/O / Modbus 閘道器 / 工業電腦
     │  輪詢、換算工程單位、時間戳記、品質標記、緩衝
     ▼
[ 傳輸層 ]  MQTT / HTTPS / OPC UA(內網)/ VPN 或專線
     │  加密、重送、離線補傳
     ▼
[ 資料與 API 層 ]  MySQL(讀值、資產、校正、告警)+ REST API
     │  驗證、授權、查詢、寫入、事件
     ▼
[ 應用與孿生層 ]  儀表板 · 告警通知 · 數位孿生模型 · 分析與預測
表 1-1:五層模型的職責、常見技術與責任歸屬
| 層級 | 主要職責 | 常見技術 | 典型責任方 |
|---|---|---|---|
| 儀表層 | 把壓力轉為可靠的電訊號或數位資料,維持精度與長期穩定 | 數位壓力錶、壓力傳送器、4–20mA、RS485、HART | 昶特 ATLANTIS 提供儀表與規格;客戶決定量測點 |
| 邊緣層 | 採集、換算、加時間戳記、標記品質、暫存緩衝 | PLC、遠端 I/O、Modbus 閘道器、Node-RED、Python 服務 | 客戶 OT 團隊或系統整合商 |
| 傳輸層 | 安全可靠地把資料從廠區送到資料庫 | MQTT、HTTPS、OPC UA、VPN | 客戶 IT 與 OT 共同 |
| 資料與 API 層 | 儲存、查詢、權限、告警規則、對外服務 | MySQL、REST API、訊息佇列 | 客戶 IT 或軟體團隊 |
| 應用與孿生層 | 呈現、分析、推演、決策支援 | Grafana 類儀表板、自建網頁、3D 或資產模型 | 客戶 IT、資料團隊或外部顧問 |
這張表有一個重點:昶特 ATLANTIS 的責任集中在第一層。我們確保儀表本身的量測原理、精度、材質、防護等級與輸出介面符合現場需求。從第二層開始,是客戶自己的系統與團隊,我們不提供雲端平台或 AWS 整合服務。這個邊界必須在專案初期就講清楚,避免後期因期待落差導致爭議。
1.2 與 Purdue 模型和 ISA-95 的對應
資安與自動化領域常用 Purdue 參考模型描述工廠網路分層,IEC 62443 也是以區域(Zone)與管道(Conduit)的觀念來設計防護。把本文的五層對應過去,可以幫助 IT 與 OT 用同一套語言討論邊界。
表 1-2:五層模型與 Purdue 層級對照
| 本文分層 | 約略對應 Purdue 層級 | 網路特性 | 設計重點 |
|---|---|---|---|
| 儀表層 | Level 0(現場設備) | 類比迴路、RS485 現場匯流排 | 接地、屏蔽、迴路供電、防護等級 |
| 邊緣層 | Level 1–2(控制與監控) | 控制網路,可靠度優先 | 不影響原有控制迴路,採唯讀方式取資料 |
| 傳輸層 | Level 3–3.5(營運與 DMZ) | 跨區流量,需分區控管 | 單向或受控的資料流、不開放反向連入 |
| 資料與 API 層 | Level 4(企業網路) | 一般 IT 網路 | 身分驗證、稽核、備份、高可用 |
| 應用與孿生層 | Level 4–5(企業與雲) | 一般 IT 或雲端 | 權限分級、資料遮罩、版本管理 |
1.3 拉取(Pull)與推送(Push):兩種資料流方式
資料從邊緣送到資料庫,基本上有兩種模式。拉取是資料庫端或應用端定期向邊緣設備要資料,推送是邊緣設備在有資料時主動送出。工業現場多半建議採用推送,原因在於資安與可靠度:推送模式只需要廠區網路對外開放「出站」連線,不需要在防火牆上開「入站」埠讓外部連進控制網路。
- 推送(建議):邊緣閘道器以 MQTT 或 HTTPS POST 把批次讀值送往資料庫前端的接收服務。斷線時閘道器本地緩衝,連線恢復後補傳。
- 拉取(有條件使用):僅限於同一個受控網段內,例如資料庫伺服器與閘道器同在 DMZ,由內部服務定期向閘道器查詢。
- 混合:即時告警用推送,歷史補齊用拉取。
1.4 資料量估算:先算清楚再選資料庫
很多專案在初期只接十幾個壓力點,覺得資料量很小,等到擴到數百個點才發現資料庫撐不住。先做一次粗估,可以提早決定要不要分區、降採樣或改用時序資料庫。下表以每筆讀值約 100 位元組(含索引的粗估)計算。
表 1-3:不同點位數與取樣週期下的資料量粗估
| 點位數 | 取樣週期 | 每日筆數 | 每年筆數 | 每年儲存量粗估 |
|---|---|---|---|---|
| 50 | 60 秒 | 72,000 | 約 2,630 萬 | 約 2.6 GB |
| 50 | 10 秒 | 432,000 | 約 1.58 億 | 約 15.8 GB |
| 200 | 60 秒 | 288,000 | 約 1.05 億 | 約 10.5 GB |
| 200 | 10 秒 | 1,728,000 | 約 6.31 億 | 約 63 GB |
| 1,000 | 10 秒 | 8,640,000 | 約 31.5 億 | 約 315 GB |
| 1,000 | 1 秒 | 86,400,000 | 約 315 億 | 約 3.15 TB |
從表中可以看出,取樣週期對資料量的影響遠大於點位數。多數公用系統(冷卻水、壓縮空氣、空調)的壓力變化是分鐘等級,60 秒甚至 30 秒取樣已經足夠;只有泵浦起停、水錘、液壓脈動等快速事件才需要秒級以下的取樣,而且通常只在事件觸發時才高頻記錄。
設計原則:用事件驅動取代全程高頻。平時以 30–60 秒記錄趨勢;當壓力變化率超過門檻或越過告警線時,邊緣端自動切換為 1 秒記錄並保留前後各數分鐘的緩衝,事件結束再降回低頻。這樣既不漏掉關鍵瞬間,也不會讓資料庫被無意義的穩態資料淹沒。
1.5 為什麼從壓力開始,而不是一次接全廠
整合專案最常見的失敗模式,是範圍一開始就太大:想一次接全廠、所有參數、所有系統。結果是現場施工拖延、資料格式不一致、各系統責任不清,三個月後仍然沒有任何一張可用的儀表板。更務實的做法是選一個有明確痛點的公用系統,先打通「儀表到 API 到儀表板」的完整鏈路,驗證資料品質與團隊協作流程,再複製到下一個系統。
壓力量測適合當作起點,有四個原因。第一,壓力與流量、液位、洩漏、堵塞等現象有直接關係,一個壓力點往往能提供多重診斷資訊。第二,壓力儀表的介面標準化程度高,4–20mA 與 RS485 幾乎是通用語言。第三,單點成本與安裝複雜度相對低,試點風險小。第四,壓力異常通常有明確的工程判斷準則,容易設定第一批告警規則並看到成效。
1.6 第一個試點的建議範圍
點位數
建議 10–30 點,涵蓋同一個系統的不同節點,例如冷卻水泵浦出口、主管、各支管與回水。
時間
四到八週完成:兩週選型與現場勘查、兩週施工與接線、兩到四週資料驗證與告警調校。
成功標準
資料完整率達 99% 以上、至少抓到一次人工巡檢沒發現的異常、IT 與 OT 雙方都能獨立說明各層責任。
第 2 章:OT 端——訊號、通訊介面與量測資料品質
資料庫裡的每一筆讀值,品質都取決於最前端那支儀表與它的訊號路徑。IT 團隊常見的誤解是「資料進來了就是對的」,但實際上,從感測元件到資料庫之間,至少有感測誤差、類比轉換誤差、換算誤差、時間誤差四種誤差來源。本章從 OT 的角度,把這些細節講清楚,讓資料表設計與 API 設計有正確的基礎。
2.1 數位壓力錶與壓力傳送器:兩種不同的角色
數位壓力錶與壓力傳送器常被混為一談,但在整合設計上扮演的角色不同。數位壓力錶以現場顯示為主要功能,操作人員走到現場就能讀值,部分型號另外提供類比輸出、RS485 或藍芽,作為資料採集的選配。壓力傳送器則以訊號輸出為核心,把壓力轉成標準電訊號送往控制系統,現場顯示是輔助。
如果目標是進入 MySQL 與 API,兩者都可以使用,選擇的關鍵在於現場需求:製程人員是否需要隨時在現場看讀值?是否需要現場快速校零?是否有多個點需要走同一條 RS485 匯流排?昶特產品目錄中,DPG 系列數位壓力錶與 SDPT、SPT 系列傳送器可依這些需求搭配,實際輸出選項依型號與訂購規格而異,下單前請務必以規格書與報價內容確認。
2.2 五種常見輸出介面比較
表 2-1:數位壓力儀表常見輸出介面比較
| 介面 | 訊號形式 | 優點 | 限制 | 適合場景 |
|---|---|---|---|---|
| 4–20mA | 電流迴路,兩線式迴路供電居多 | 抗干擾佳、可長距離傳輸、可偵測斷線 | 一對線一個變數,需 PLC 或 I/O 模組轉為數位 | 既有 PLC/DCS 系統、最廣泛的現場標準 |
| 0–10V | 電壓訊號 | 接線簡單、與樓宇控制器相容 | 線路壓降與干擾影響較大,距離短 | BMS、空調控制箱附近的短距離點位 |
| RS485 Modbus RTU | 數位串列匯流排,多點連接 | 一條線掛多台、可讀多個暫存器(壓力、溫度、狀態) | 需設定位址與通訊參數,匯流排需終端電阻與接地規劃 | 點位密集、希望減少佈線、需要讀取診斷資料 |
| HART | 在 4–20mA 上疊加數位訊號 | 不改線就能讀取設備資訊與診斷 | 需要 HART 數據機或多工器,更新速率較慢 | 既有 4–20mA 迴路上要加值,做遠端組態與診斷 |
| 藍芽 | 短距離無線 | 現場用手機讀值、設定、抽查記錄 | 不適合作為全廠資料主幹,距離與穩定性受環境影響 | 巡檢輔助、現場校正、臨時量測 |
提醒:藍芽功能適合巡檢與現場設定,但不建議當成 IT/OT 整合的主要資料通道。要進入資料庫的點位,仍應以 4–20mA、RS485 或 HART 這類有線介面為主,確保連續性與可稽核性。
2.3 4–20mA 迴路:換算、斷線偵測與解析度
4–20mA 是壓力量測最普遍的標準。4 mA 代表量程下限,20 mA 代表量程上限,中間成線性關係。邊緣端的換算公式很簡單:
壓力 P = P_min + (I - 4) / 16 × (P_max - P_min)

例:量程 0–10 bar,量到 12 mA
P = 0 + (12 - 4) / 16 × 10 = 5.0 bar
這個「活零點」設計的好處,是可以區分「0 壓力」與「斷線」。依 NAMUR NE43 的建議,正常量測範圍大約落在 3.8 到 20.5 mA,低於 3.6 mA 或高於 21 mA 通常被視為迴路故障(斷線、短路、感測器失效)。邊緣端在換算前,應先判斷電流是否落在合理範圍,超出就把該筆資料標記為品質不良,而不是直接換算成一個看似正常的壓力值寫進資料庫。
另一個常被忽略的是類比輸入的解析度。以 250 Ω 精密電阻把 4–20mA 轉成 1–5V 為例,不同位元數的類比轉換器,對應的最小可辨識變化量如下:
表 2-2:不同類比轉換器位元數對應的量測解析度(以 0–5V 輸入、1–5V 有效範圍估算)
| 轉換器位元數 | 每計數電壓 | 有效範圍內計數 | 約佔量程比例 | 對 0–10 bar 量程約相當於 |
|---|---|---|---|---|
| 10 位元 | 約 4.88 mV | 約 819 | 約 0.122% | 約 0.0122 bar |
| 12 位元 | 約 1.22 mV | 約 3,277 | 約 0.031% | 約 0.0031 bar |
| 16 位元 | 約 76.3 μV | 約 52,429 | 約 0.0019% | 約 0.0002 bar |
如果儀表本身精度是 ±0.5% FS,用 10 位元的轉換器就會讓解析度成為瓶頸;12 位元以上才能讓轉換誤差相對於儀表誤差變得可以忽略。對於 ±0.1% 以內的高精度儀表,建議使用 16 位元的輸入模組,否則儀表的高精度在資料端被浪費。
2.4 RS485 Modbus RTU:位址、暫存器與現場佈線
RS485 的優勢是一條雙絞線可以掛多台儀表,除了壓力值,還可以同時讀取溫度、設備狀態、診斷旗標。要把它穩定地接進資料鏈,需要注意以下設計要點:
- 通訊參數:每台儀表需設定唯一的從站位址,鮑率、同位元、停止位元整條匯流排必須一致。
- 匯流排拓樸:採手牽手式(菊鍊)而非星狀,兩端各加一個 120 Ω 終端電阻,避免反射。
- 距離與速率:鮑率越高可傳輸的距離越短,一般 9600 bps 在良好佈線下可達上千公尺等級,但仍需依電纜品質與干擾環境評估。
- 屏蔽與接地:使用屏蔽雙絞線,屏蔽層單點接地,避免形成接地環路。
- 暫存器對照表:向儀表供應商取得完整的暫存器位址、資料型態(16 位元整數、32 位元浮點)、位元組順序(Big-endian 或 word-swap)與比例係數。
暫存器對照表是 IT 與 OT 溝通最容易出錯的地方。同一個 32 位元浮點數,不同儀表可能採用不同的字組順序,如果邊緣端解析錯誤,讀值會是完全不合理的數字。建議每一款儀表建立一份「通訊規格卡」,並在試點階段用手持標準器比對確認:
表 2-3:儀表通訊規格卡範本(欄位說明)
| 欄位 | 說明 | 範例(示意,非實際型號) |
|---|---|---|
| 從站位址 | 匯流排上唯一識別 | 12 |
| 通訊參數 | 鮑率/資料位元/同位/停止位元 | 9600/8/N/1 |
| 功能碼 | 讀取保持暫存器或輸入暫存器 | 03 或 04 |
| 壓力暫存器 | 起始位址、長度、資料型態 | 0x0000,2 字組,32 位元浮點 |
| 位元組順序 | 決定如何拼接兩個字組 | 以規格書為準,現場實測確認 |
| 工程單位 | 讀值單位與可否切換 | bar 或 kPa(以儀表設定為準) |
| 診斷暫存器 | 感測器故障、過載、電池、溫度 | 依規格書提供 |
2.5 誤差預算:資料到底準不準
進入資料庫的壓力值,誤差不只來自儀表。完整的誤差預算至少包含:儀表本身精度、溫度影響、類比轉換誤差、換算捨入、安裝誤差(取壓位置與高度差)。若各誤差來源彼此獨立,可以用方和根(RSS)估算整體不確定度:
U_total = √( U_儀表² + U_溫度² + U_ADC² + U_安裝² )

例:U_儀表 = 0.5%,U_溫度 = 0.2%,U_ADC = 0.05%,U_安裝 = 0.1%
U_total = √(0.25 + 0.04 + 0.0025 + 0.01) ≈ 0.55% FS這個估算說明了一件事:在儀表精度為主要誤差來源時,花大錢升級類比轉換器效益有限,反過來,若儀表本身是 ±0.1% 的高精度款,卻接到解析度不足的輸入模組,整體精度就會被拖累。選型時應讓各環節的誤差量級相近,避免在某一環過度投資。
2.6 資料品質標記:讓壞資料有名字
工業資料最危險的不是「沒有資料」,而是「看起來正常、其實不可信的資料」。邊緣端與資料庫應該共同約定一組品質代碼,隨每筆讀值一起儲存,讓下游的分析、告警與數位孿生都能判斷該不該採信。
表 2-4:建議的資料品質代碼
| 代碼 | 名稱 | 判定條件 | 下游處理建議 |
|---|---|---|---|
| 0 | GOOD | 通訊正常、數值在合理範圍 | 正常使用 |
| 1 | UNCERTAIN | 剛開機、剛校正、溫度補償尚未穩定 | 可顯示,但不觸發告警 |
| 2 | BAD_COMM | 通訊逾時、CRC 錯誤、閘道器離線 | 不寫入數值,記錄為缺漏事件 |
| 3 | BAD_SENSOR | 電流低於 3.6 mA 或高於 21 mA、儀表自診斷故障 | 觸發維修工單,不可用於分析 |
| 4 | OUT_OF_RANGE | 超出儀表量程或超出合理物理範圍 | 保留原始值供檢討,不納入統計 |
| 5 | STALE | 數值長時間完全不變(疑似凍結) | 標記疑似卡值,提示現場檢查 |
| 6 | MAINTENANCE | 該點位處於校正或維修狀態 | 暫停告警,保留記錄 |
2.7 時間:最容易被低估的資料欄位
壓力異常往往需要和泵浦起停、閥門動作、製程批次對時間線,如果各系統的時間不同步,因果關係就無從判斷。實務上有幾個原則:邊緣端在採集當下就打上時間戳記,不要等到入庫才由資料庫補;全系統一律儲存 UTC 時間,僅在顯示層轉換為本地時區;閘道器與伺服器都應同步到可靠的時間源(NTP),並定期監控時間偏移。
另外,要區分「測量時間」與「接收時間」兩個欄位。當網路中斷後補傳資料時,測量時間反映真實的物理事件,接收時間反映資料抵達的時刻,兩者的差距本身也是一項有價值的健康指標。
第 3 章:MySQL 資料層——資料表設計、寫入策略與保存期限
MySQL 是許多企業最熟悉、最容易取得維運人力的資料庫。對於數百到數千個壓力點、分鐘到十秒級的取樣,MySQL 8 搭配良好的資料表設計與分區策略,完全可以勝任。本章的重點不是教您 SQL 語法,而是說明為什麼這樣設計,讓您能依自己的規模調整。
3.1 先決定:MySQL 夠用嗎?
在動手之前,先誠實評估資料庫選型。MySQL 是通用關聯式資料庫,不是時序資料庫,兩者各有適用範圍。
表 3-1:MySQL 與時序資料庫的適用情境比較
| 評估面向 | MySQL 8(含分區) | 專用時序資料庫 |
|---|---|---|
| 團隊熟悉度 | 多數 IT 團隊已具備維運經驗 | 需要額外學習與維運投入 |
| 資產、校正、告警等關聯資料 | 非常適合,可用外鍵與交易 | 通常需另配關聯式資料庫 |
| 高頻寫入(每秒數萬筆以上) | 需批次寫入與調校,達上限較早 | 為此設計,壓縮與寫入效率較佳 |
| 長期保存與降採樣 | 需自行排程彙總與分區刪除 | 多半內建保留策略與連續彙總 |
| 與既有應用整合 | 驅動與工具生態完整 | 視產品而定 |
| 建議使用時機 | 點位數百至數千、取樣 10 秒以上、已有 MySQL 維運能力 | 點位數千以上且高頻取樣,或需要大量長期時序分析 |
一個務實的做法是兩者並用:MySQL 保存資產主檔、儀表資訊、校正紀錄、告警事件等「關聯性強、量不大」的資料;讀值歷史若成長到 MySQL 吃力,再把歷史讀值搬到時序資料庫,API 層對外維持同一份介面,應用端不必改動。本文的資料表設計採用這個思路,讀值表與主檔表邊界清楚,日後要搬遷也容易。
3.2 資料表總覽
表 3-2:核心資料表與用途
| 資料表 | 用途 | 成長特性 |
|---|---|---|
| assets | 資產階層:廠區、區域、系統、設備 | 很少變動,數百到數千列 |
| instruments | 儀表主檔:型號、序號、量程、輸出介面、安裝日期 | 很少變動 |
| tags | 量測點(Tag):單位、量程、告警限值、所屬資產與儀表 | 很少變動 |
| calibrations | 校正紀錄:日期、偏差、證書編號、下次到期 | 緩慢成長 |
| readings | 讀值歷史(核心大表,需分區) | 快速成長 |
| readings_1min | 分鐘級彙總(平均、最大、最小、筆數) | 中度成長,保存較久 |
| tag_latest | 每個點位的最新值,供儀表板快速查詢 | 固定列數,頻繁更新 |
| alarms | 告警事件與狀態 | 視告警頻率 |
| ingest_errors | 寫入失敗或被拒絕的資料(死信區) | 應維持很小,變大代表有問題 |
3.3 資產、儀表與點位:主檔設計
主檔設計決定了日後數位孿生能不能順利對應。核心觀念是把「資產」「儀表」「點位」三者分開:資產是工廠裡實際存在的東西(泵浦、過濾器、冷卻水主管),儀表是可被更換的量測設備,點位則是「某個資產上的某個量測意義」(泵浦出口壓力)。儀表壞了換新,點位與資產不變,歷史資料就不會斷。
CREATE TABLE assets (
  asset_id      INT UNSIGNED NOT NULL AUTO_INCREMENT,
  parent_id     INT UNSIGNED NULL,
  asset_code    VARCHAR(64)  NOT NULL,          -- 例:FAB1-CW-PUMP01
  name          VARCHAR(128) NOT NULL,
  asset_type    VARCHAR(32)  NOT NULL,          -- site / area / system / equipment
  PRIMARY KEY (asset_id),
  UNIQUE KEY uk_asset_code (asset_code),
  KEY idx_parent (parent_id),
  CONSTRAINT fk_asset_parent FOREIGN KEY (parent_id) REFERENCES assets(asset_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

CREATE TABLE instruments (
  instrument_id INT UNSIGNED NOT NULL AUTO_INCREMENT,
  model         VARCHAR(64)  NOT NULL,
  serial_no     VARCHAR(64)  NOT NULL,
  range_min     DOUBLE NOT NULL,
  range_max     DOUBLE NOT NULL,
  range_unit    VARCHAR(16)  NOT NULL,          -- bar / kPa / mbar ...
  output_type   VARCHAR(32)  NOT NULL,          -- 4-20mA / RS485 / HART ...
  installed_at  DATE NULL,
  PRIMARY KEY (instrument_id),
  UNIQUE KEY uk_serial (model, serial_no)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

CREATE TABLE tags (
  tag_id        INT UNSIGNED NOT NULL AUTO_INCREMENT,
  tag_name      VARCHAR(96)  NOT NULL,          -- 例:FAB1.CW.PUMP01.DISCH_P
  asset_id      INT UNSIGNED NOT NULL,
  instrument_id INT UNSIGNED NULL,
  measure_type  VARCHAR(32)  NOT NULL,          -- pressure / diff_pressure / level / temp
  eng_unit      VARCHAR(16)  NOT NULL,
  scan_sec      SMALLINT UNSIGNED NOT NULL DEFAULT 60,
  lo_lo DOUBLE NULL, lo DOUBLE NULL, hi DOUBLE NULL, hi_hi DOUBLE NULL,
  deadband      DOUBLE NOT NULL DEFAULT 0,
  is_active     TINYINT(1) NOT NULL DEFAULT 1,
  PRIMARY KEY (tag_id),
  UNIQUE KEY uk_tag_name (tag_name),
  KEY idx_asset (asset_id),
  CONSTRAINT fk_tag_asset FOREIGN KEY (asset_id) REFERENCES assets(asset_id),
  CONSTRAINT fk_tag_inst  FOREIGN KEY (instrument_id) REFERENCES instruments(instrument_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
點位命名建議採用固定層級的句點分隔,例如「廠區.系統.設備.量測意義」。命名規則在專案初期就要定案並文件化,否則三年後會出現「PUMP1_P」「Pump01Press」「泵浦一壓力」同時存在的混亂,任何跨系統分析都會變得痛苦。
3.4 讀值大表:readings 與分區
讀值表是整個資料庫最大、寫入最頻繁的表,設計上有三個重點:主鍵讓同一點位的時間序列在磁碟上相鄰、依時間分區方便清理、不使用外鍵(分區的 InnoDB 資料表不支援外鍵)。
CREATE TABLE readings (
  tag_id     INT UNSIGNED NOT NULL,
  ts         DATETIME(3)  NOT NULL,             -- 測量時間,UTC
  value      DOUBLE       NULL,                 -- 工程單位值
  raw_value  DOUBLE       NULL,                 -- 原始值(如 mA),可選
  quality    TINYINT UNSIGNED NOT NULL DEFAULT 0,
  recv_ts    DATETIME(3)  NOT NULL DEFAULT CURRENT_TIMESTAMP(3),
  PRIMARY KEY (tag_id, ts)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4
PARTITION BY RANGE COLUMNS (ts) (
  PARTITION p202610 VALUES LESS THAN ('2026-11-01'),
  PARTITION p202611 VALUES LESS THAN ('2026-12-01'),
  PARTITION p202612 VALUES LESS THAN ('2027-01-01'),
  PARTITION pmax    VALUES LESS THAN (MAXVALUE)
);
主鍵採用 (tag_id, ts) 的好處有兩個。其一,InnoDB 的叢集索引會依主鍵排序,同一點位的連續時間資料會物理上聚集,查詢「某點位過去 24 小時」時只需讀取連續的資料頁。其二,主鍵天然提供冪等性:同一點位同一時間戳記的資料不會重複寫入,網路重送造成的重複資料可以被安全地忽略或覆寫。
每月建立一個分區,預先建立未來數個月的分區,並用排程在月底前新增下一個月、刪除超過保存期限的舊分區。刪除分區(DROP PARTITION)幾乎是瞬間完成,遠比對大表執行 DELETE 快,也不會產生大量交易日誌與碎片。
常見陷阱:忘記預先建立未來分區,月初資料就會全部落進 MAXVALUE 分區,日後拆分很費工。建議用排程每週檢查,確保至少有兩個月的預建分區,並在監控中加入「剩餘分區數」告警。
3.5 寫入策略:批次、冪等與背壓
逐筆 INSERT 是效能殺手。每一筆都要經過網路往返、解析、交易提交,數百個點位每十秒各寫一筆,就會讓資料庫忙於處理大量微小交易。正確做法是邊緣端或接收服務累積一小批(例如 500 到 5,000 筆)再一次寫入,使用多值 INSERT 或載入檔案方式。
INSERT INTO readings (tag_id, ts, value, raw_value, quality)
VALUES
  (101, '2026-10-28 03:10:00.000', 4.82, 12.51, 0),
  (102, '2026-10-28 03:10:00.000', 5.01, 12.82, 0),
  (103, '2026-10-28 03:10:00.000', NULL, 2.90, 3)
ON DUPLICATE KEY UPDATE
  value = VALUES(value), raw_value = VALUES(raw_value), quality = VALUES(quality);
其中第三筆示範了品質不良的資料:電流 2.90 mA 低於 3.6 mA,判定為感測器故障,value 留空、品質設為 3。這樣既保留了「當時發生過故障」的證據,也不會讓錯誤數值污染統計。
- 冪等:靠主鍵與 ON DUPLICATE KEY UPDATE,讓補傳與重送都是安全的。
- 背壓:當資料庫繁忙時,接收服務應回應「稍後再試」,邊緣端依指數退避重送並持續本地緩衝,而不是無限制地堆積。
- 死信區:格式錯誤或未知點位的資料不要丟棄,寫入 ingest_errors 供事後排查。
- 交易大小:單一批次不宜過大,避免長時間持有鎖與產生過大的複寫延遲。
3.6 最新值表與快速查詢
儀表板最常見的查詢是「每個點位現在是多少」。如果每次都去大表裡找最後一筆,成本會隨資料量上升。解法是另外維護一張固定列數的 tag_latest,每次批次寫入後順便更新。
CREATE TABLE tag_latest (
  tag_id   INT UNSIGNED NOT NULL,
  ts       DATETIME(3)  NOT NULL,
  value    DOUBLE NULL,
  quality  TINYINT UNSIGNED NOT NULL,
  PRIMARY KEY (tag_id)
) ENGINE=InnoDB;

INSERT INTO tag_latest (tag_id, ts, value, quality)
VALUES (101, '2026-10-28 03:10:00.000', 4.82, 0)
ON DUPLICATE KEY UPDATE
  ts = IF(VALUES(ts) >= ts, VALUES(ts), ts),
  value = IF(VALUES(ts) >= ts, VALUES(value), value),
  quality = IF(VALUES(ts) >= ts, VALUES(quality), quality);
這段語法特別處理了「補傳舊資料不應覆蓋較新的最新值」的情況:只有新資料的時間戳記不早於現有值時才更新。這是邊緣端斷線重連後最常見的資料錯亂來源之一。
3.7 降採樣:分鐘級彙總表
原始高頻資料只需保存較短期間,長期趨勢分析使用彙總即可。建議以排程每分鐘或每五分鐘,把已完成的時間區段彙總到 readings_1min。
CREATE TABLE readings_1min (
  tag_id  INT UNSIGNED NOT NULL,
  bucket  DATETIME     NOT NULL,                -- 分鐘起點,UTC
  avg_v   DOUBLE NULL, min_v DOUBLE NULL, max_v DOUBLE NULL,
  n_good  SMALLINT UNSIGNED NOT NULL,
  n_bad   SMALLINT UNSIGNED NOT NULL,
  PRIMARY KEY (tag_id, bucket)
) ENGINE=InnoDB;

INSERT INTO readings_1min (tag_id, bucket, avg_v, min_v, max_v, n_good, n_bad)
SELECT tag_id,
       DATE_FORMAT(ts, '%Y-%m-%d %H:%i:00') AS bucket,
       AVG(IF(quality = 0, value, NULL)),
       MIN(IF(quality = 0, value, NULL)),
       MAX(IF(quality = 0, value, NULL)),
       SUM(quality = 0), SUM(quality <> 0)
FROM readings
WHERE ts >= '2026-10-28 03:00:00' AND ts < '2026-10-28 03:05:00'
GROUP BY tag_id, bucket
ON DUPLICATE KEY UPDATE
  avg_v = VALUES(avg_v), min_v = VALUES(min_v), max_v = VALUES(max_v),
  n_good = VALUES(n_good), n_bad = VALUES(n_bad);
彙總時只計算品質良好的資料,同時記錄良好與不良筆數,讓使用者能判斷這一分鐘的平均值有多少可信度。最大值與最小值不可省略:平均值會抹平瞬間的壓力尖峰,而尖峰往往正是設備損傷與製程異常的關鍵證據。
3.8 常用查詢範例
以下三個查詢涵蓋了最常見的分析需求:趨勢、變化率與疑似卡值。
-- (1) 某點位最近 24 小時,每 5 分鐘一個點
SELECT FROM_UNIXTIME(FLOOR(UNIX_TIMESTAMP(ts)/300)*300) AS t5,
       AVG(value) AS avg_v, MIN(value) AS min_v, MAX(value) AS max_v
FROM readings
WHERE tag_id = 101 AND quality = 0
  AND ts >= UTC_TIMESTAMP() - INTERVAL 24 HOUR
GROUP BY t5 ORDER BY t5;

-- (2) 壓力變化率:與前一筆相比每秒變化多少(MySQL 8 視窗函式)
SELECT ts, value,
       (value - LAG(value) OVER w) /
       NULLIF(TIMESTAMPDIFF(MICROSECOND, LAG(ts) OVER w, ts) / 1000000, 0) AS dp_per_sec
FROM readings
WHERE tag_id = 101 AND ts >= UTC_TIMESTAMP() - INTERVAL 1 HOUR
WINDOW w AS (ORDER BY ts);

-- (3) 疑似卡值:最近 30 分鐘數值完全沒變
SELECT tag_id
FROM readings
WHERE ts >= UTC_TIMESTAMP() - INTERVAL 30 MINUTE AND quality = 0
GROUP BY tag_id
HAVING COUNT(*) >= 20 AND MIN(value) = MAX(value);
注意第一個查詢的 FROM_UNIXTIME 會依資料庫連線時區轉換,建議連線時固定設定為 UTC,避免顯示層與資料層的時區混淆。
3.9 保存期限與容量規劃
表 3-3:建議的分層保存策略(可依法規與稽核需求調整)
| 資料層級 | 取樣粒度 | 建議保存 | 用途 |
|---|---|---|---|
| 原始高頻事件資料 | 1 秒以下,事件觸發 | 30–90 天 | 事故事後分析、水錘與脈動研究 |
| 原始讀值 | 10–60 秒 | 6–12 個月 | 日常診斷、短期趨勢 |
| 分鐘彙總 | 1 分鐘 | 2–3 年 | 季節比較、年度檢討 |
| 小時/日彙總 | 1 小時、1 日 | 5 年以上 | 長期趨勢、設備壽命分析、稽核佐證 |
| 校正與告警紀錄 | 事件 | 依品質系統要求(常為設備壽命期間) | 稽核、追溯 |
若所屬產業有法規要求資料完整性與保存年限(例如製藥、食品、潔淨室),保存策略應先與品保單位確認,再決定彙總與刪除規則。刪除資料之前,務必確認已備份,且彙總結果已驗證正確。
第 4 章:API 層——讀取、寫入、告警與權限設計
資料庫裡有了乾淨的資料,下一步是讓各種應用安全地使用它。直接讓儀表板、報表工具、分析腳本都連進資料庫,短期看似省事,長期會造成權限失控、查詢互相拖累、資料結構變動牽動所有下游。引入 API 層,等於在資料庫與使用者之間建立一道清楚的契約:外界只能透過受控的介面存取資料,資料庫內部可以自由演進。
4.1 API 要解決的四件事
- 寫入:讓邊緣閘道器安全、冪等地送入讀值。
- 讀取:讓儀表板與分析工具查詢最新值、歷史趨勢、資產狀態。
- 事件:告警的產生、確認與關閉,以及對外通知。
- 主檔:點位、資產、儀表、校正資訊的查詢與維護。
4.2 端點設計總覽
表 4-1:REST API 端點設計範例
| 方法與路徑 | 用途 | 主要使用者 | 權限 |
|---|---|---|---|
| POST /api/v1/ingest/readings | 批次寫入讀值,冪等 | 邊緣閘道器 | 寫入專用金鑰 |
| GET /api/v1/tags | 列出點位與其單位、限值 | 儀表板、整合應用 | 唯讀 |
| GET /api/v1/tags/{id}/latest | 單一點位最新值與品質 | 儀表板 | 唯讀 |
| GET /api/v1/tags/{id}/readings | 歷史讀值,可指定時間範圍與彙總粒度 | 分析、報表 | 唯讀 |
| GET /api/v1/assets/{id}/state | 資產綜合狀態(供數位孿生使用) | 孿生模型、儀表板 | 唯讀 |
| GET /api/v1/alarms | 查詢告警,可依狀態與時間篩選 | 維運人員 | 唯讀 |
| POST /api/v1/alarms/{id}/ack | 確認告警 | 維運人員 | 具備確認權限的使用者 |
| GET /api/v1/instruments/{id}/calibrations | 校正歷史與到期日 | 品保、維護 | 唯讀 |
路徑中的 v1 代表版本。契約一旦對外開放,就不應該隨意破壞;新增欄位屬於向後相容,可以直接加入,欄位更名、型別變更或移除則應發布 v2,並讓 v1 保留一段轉換期。
4.3 寫入端點:批次、冪等與部分成功
寫入端點是整條鏈路最容易出事的地方,設計上要處理網路重送、部分資料錯誤、時間戳記異常與流量尖峰。請求格式範例如下:
POST /api/v1/ingest/readings
Authorization: Bearer <gateway-api-key>
Idempotency-Key: gw-fab1-20261028T031000Z-0001
Content-Type: application/json

{
  "gateway_id": "gw-fab1-cw-01",
  "readings": [
    { "tag": "FAB1.CW.PUMP01.DISCH_P", "ts": "2026-10-28T03:10:00.000Z",
      "value": 4.82, "raw": 12.51, "quality": 0 },
    { "tag": "FAB1.CW.PUMP01.SUCT_P",  "ts": "2026-10-28T03:10:00.000Z",
      "value": null, "raw": 2.90, "quality": 3 }
  ]
}
回應採用「部分成功」模式。一批資料中若有幾筆格式錯誤,不應讓整批失敗,而是回報每一筆的處理結果,由邊緣端決定重送哪些:
HTTP/1.1 207 Multi-Status
{
  "accepted": 1,
  "rejected": 1,
  "errors": [
    { "index": 1, "code": "UNKNOWN_TAG",
      "message": "tag FAB1.CW.PUMP01.SUCT_P not registered" }
  ]
}
表 4-2:寫入端點建議的驗證規則
| 驗證項目 | 規則 | 不符時處理 |
|---|---|---|
| 點位是否存在 | tag 必須已在 tags 表且為啟用狀態 | 拒絕該筆,寫入死信區,回報 UNKNOWN_TAG |
| 時間戳記格式 | 必須為 ISO 8601 且為 UTC | 拒絕,回報 BAD_TIMESTAMP |
| 未來時間 | 不得晚於伺服器時間超過 5 分鐘 | 拒絕,並提示檢查閘道器時鐘 |
| 過舊時間 | 超過允許補傳期限(例如 7 天)需特殊流程 | 拒絕或轉入人工補資料流程 |
| 數值合理性 | 在點位定義的物理範圍內(可略寬於量程) | 仍可寫入,但品質改為 OUT_OF_RANGE |
| 批次大小 | 單批上限(例如 5,000 筆) | 超過回應 413,請閘道器分批 |
| 重複請求 | 相同 Idempotency-Key 在有效期內只處理一次 | 回傳先前結果,不重複寫入 |
4.4 讀取端點:彙總、分頁與效能保護
歷史查詢是最容易被濫用的端點。使用者要求「過去一年、每秒一筆」的資料,就足以讓資料庫癱瘓。API 必須主動保護資料庫:限制單次查詢的時間範圍與回傳筆數、依查詢區間自動選擇資料來源(短區間用原始資料、長區間用彙總表)、並支援游標分頁。
GET /api/v1/tags/101/readings?from=2026-10-27T00:00:00Z&to=2026-10-28T00:00:00Z&interval=5m&agg=avg,min,max

{
  "tag": "FAB1.CW.PUMP01.DISCH_P",
  "unit": "bar",
  "interval": "5m",
  "points": [
    { "t": "2026-10-27T00:00:00Z", "avg": 4.81, "min": 4.77, "max": 4.86, "good": 30, "bad": 0 },
    { "t": "2026-10-27T00:05:00Z", "avg": 4.80, "min": 4.76, "max": 4.85, "good": 30, "bad": 0 }
  ],
  "next_cursor": null
}
表 4-3:依查詢區間自動選擇資料來源的建議規則
| 查詢區間 | 資料來源 | 最大回傳點數建議 |
|---|---|---|
| 6 小時以內 | readings 原始資料 | 約 2,000 點 |
| 6 小時到 7 天 | readings_1min 彙總 | 約 10,000 點 |
| 7 天到 1 年 | 小時彙總 | 約 9,000 點 |
| 超過 1 年 | 日彙總 | 依需求 |
4.5 錯誤格式與狀態碼
一致的錯誤格式能大幅降低整合成本。建議採用 RFC 7807(Problem Details)的結構,包含類型、標題、狀態碼與可讀的說明。狀態碼的使用要遵循慣例:400 代表請求本身有誤、401 代表未通過驗證、403 代表已驗證但無權限、404 代表資源不存在、409 代表衝突(例如重複確認告警)、413 代表請求過大、429 代表流量超限、503 代表暫時無法服務。其中 429 與 503 都應附上 Retry-After,讓邊緣端知道多久後重試。
4.6 驗證與授權:機器與人要分開
- 邊緣閘道器:使用專屬的 API 金鑰或雙向 TLS 憑證,權限僅限寫入讀值,且綁定特定閘道器 ID。金鑰可定期輪替,洩漏時可單獨撤銷,不影響其他閘道器。
- 人員與應用:使用企業的身分提供者(OIDC/OAuth 2.0),發放短效 Token,依角色控管。例如操作員可確認告警、工程師可修改告警限值、稽核員只能查閱。
- 最小權限:讀取專用的帳號不得具備寫入權限;資料庫連線帳號也應依 API 的用途分開。
- 稽核紀錄:所有寫入與設定變更記錄操作者、時間、前後值,尤其是告警限值與校正資料的修改。
- 傳輸加密:全面使用 TLS,內網也不例外。
4.7 告警:避免「狼來了」
告警設計不佳是監控專案失敗的首要原因。值班人員被每天上百則誤報淹沒,一個月後就會開始忽略所有通知,真正的異常反而被淹沒。以下是降低誤報的四個機制:
- 延遲確認(On-delay):壓力越線必須持續一段時間(例如 30 秒)才算告警,過濾瞬間尖峰。
- 遲滯(Deadband):告警解除的門檻比觸發門檻寬鬆一點,避免讀值在門檻附近來回跳動造成反覆告警。
- 品質閘門:品質不良的資料不觸發壓力告警,而是觸發「儀表或通訊異常」這個獨立類型的告警。
- 分級與抑制:區分警告與緊急,並在維修狀態下暫停該點位的告警。
CREATE TABLE alarms (
  alarm_id    BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
  tag_id      INT UNSIGNED NOT NULL,
  alarm_type  VARCHAR(24) NOT NULL,   -- HI / HI_HI / LO / LO_LO / RATE / BAD_SENSOR / STALE
  severity    TINYINT UNSIGNED NOT NULL,
  state       VARCHAR(12) NOT NULL,   -- ACTIVE / ACKED / CLEARED
  triggered_at DATETIME(3) NOT NULL,
  trigger_value DOUBLE NULL,
  acked_at    DATETIME(3) NULL,
  acked_by    VARCHAR(64) NULL,
  cleared_at  DATETIME(3) NULL,
  note        VARCHAR(255) NULL,
  PRIMARY KEY (alarm_id),
  KEY idx_tag_state (tag_id, state),
  KEY idx_time (triggered_at),
  CONSTRAINT fk_alarm_tag FOREIGN KEY (tag_id) REFERENCES tags(tag_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
4.8 邊緣端範例:把兩個暫存器解成浮點數
下面是邊緣端解析 Modbus 暫存器的簡化範例,示範字組順序處理與 4–20mA 換算及品質判定。請依您所用的 Modbus 函式庫與儀表規格書調整,這裡只是概念說明,不是可直接上線的完整程式。
import struct

def decode_float32(regs, word_swap=False):
    """regs: 兩個 16 位元暫存器值;word_swap 依儀表規格書決定"""
    hi, lo = (regs[1], regs[0]) if word_swap else (regs[0], regs[1])
    return struct.unpack(">f", struct.pack(">HH", hi, lo))[0]

def ma_to_pressure(i_ma, p_min, p_max):
    """4–20mA 換算並判定品質;回傳 (value, quality)"""
    if i_ma < 3.6 or i_ma > 21.0:
        return None, 3                      # BAD_SENSOR
    value = p_min + (i_ma - 4.0) / 16.0 * (p_max - p_min)
    if value < p_min - 0.02 * (p_max - p_min) or value > p_max * 1.05:
        return value, 4                     # OUT_OF_RANGE
    return value, 0                         # GOOD
4.9 API 的非功能需求
表 4-4:API 上線前建議確認的非功能需求
| 面向 | 需確認事項 |
|---|---|
| 可用性 | 接收服務是否可水平擴充?資料庫故障時邊緣端緩衝可撐多久? |
| 延遲 | 從儀表量測到儀表板顯示的端到端延遲目標(例如 15 秒內) |
| 流量控制 | 每個金鑰的速率限制、批次大小上限、突發流量的處理 |
| 文件 | 以 OpenAPI 規格維護,並提供範例請求與錯誤碼表 |
| 可觀測性 | 請求量、錯誤率、寫入延遲、死信區筆數、各閘道器最後上線時間 |
| 備份與還原 | 資料庫備份頻率、還原演練紀錄、分區表備份方式 |
| 相容性 | 版本策略、廢止通知期限 |
第 5 章:數位孿生——把壓力資料變成可推演的資產模型
「數位孿生」是近年被過度使用的詞,從簡單的 3D 看板到複雜的物理模擬都自稱孿生。對工程師而言,與其爭論定義,不如問一個實際的問題:這個模型能不能回答「接下來會發生什麼」與「如果我這樣做會怎樣」?只能顯示「現在是多少」的,是儀表板;能比對「應該是多少」、「趨勢往哪走」、「改變條件會如何」的,才開始具備孿生的價值。本章以壓力資料為核心,說明如何循序漸進建立有用的資產模型。
5.1 孿生成熟度的四個階段
表 5-1:以壓力資料為基礎的孿生成熟度
| 階段 | 名稱 | 能力 | 所需資料 | 技術難度 |
|---|---|---|---|---|
| 1 | 數位模型 | 資產階層與關係的靜態描述,手動更新 | 主檔資料 | 低 |
| 2 | 數位影子 | 資產狀態即時反映現場,單向資料流(現場到模型) | 即時讀值、品質、告警 | 低至中 |
| 3 | 診斷與預測 | 比對預期值、偵測偏離、估算趨勢與到達限值的時間 | 歷史讀值、運轉條件(流量、轉速、溫度) | 中 |
| 4 | 推演與最佳化 | 改變條件進行假設分析,提出建議,必要時回寫控制 | 完整的製程模型、驗證過的物理或統計模型 | 高 |
多數工廠現階段最有價值、風險也最低的目標是階段 2 到階段 3。階段 4 的「回寫控制」涉及製程安全,需要完整的功能安全評估與責任界定,不建議作為首批專案目標。本文的設計預設為唯讀架構:模型從現場取資料、產生建議,由人決定是否採取行動。
5.2 資產模型:用關係描述系統
孿生的骨架是資產之間的關係。冷卻水迴路不是一堆獨立的壓力點,而是「水源槽 → 泵浦 → 過濾器 → 主管 → 支管 → 負載 → 回水」這條有方向的路徑。把這種上下游關係存進資料庫,才能做到「下游壓力異常時,自動往上游找原因」。
CREATE TABLE asset_links (
  from_asset_id INT UNSIGNED NOT NULL,
  to_asset_id   INT UNSIGNED NOT NULL,
  link_type     VARCHAR(24)  NOT NULL,     -- FEEDS / RETURNS / CONTAINS / MEASURES
  PRIMARY KEY (from_asset_id, to_asset_id, link_type),
  KEY idx_to (to_asset_id)
) ENGINE=InnoDB;
有了這張關係表,API 可以提供「資產狀態」端點,把某個資產及其相關點位、告警、校正狀態彙整成一份文件,孿生模型與儀表板都用這份文件作為輸入:
GET /api/v1/assets/812/state

{
  "asset": { "id": 812, "code": "FAB1-CW-FILTER01", "type": "equipment" },
  "upstream":   [ { "id": 811, "code": "FAB1-CW-PUMP01" } ],
  "downstream": [ { "id": 813, "code": "FAB1-CW-HEADER" } ],
  "measurements": {
    "inlet_p":  { "value": 4.62, "unit": "bar", "quality": 0, "ts": "2026-10-28T03:10:00Z" },
    "outlet_p": { "value": 4.14, "unit": "bar", "quality": 0, "ts": "2026-10-28T03:10:00Z" },
    "delta_p":  { "value": 0.48, "unit": "bar", "derived": true }
  },
  "health": { "score": 82, "status": "WATCH", "reasons": ["delta_p_trend_rising"] },
  "calibration": { "due": "2027-03-15", "overdue": false },
  "alarms": []
}
注意 delta_p 是「衍生量」,由進出口兩個壓力點即時計算,而不是另外裝一個儀表。這是數位孿生很實用的特色:用已有的量測推算出沒有直接量測的量。但衍生量的品質取決於所有輸入的品質,只要任一個輸入品質不良,衍生量就必須標記為不可信。
5.3 預期值模型:先有「應該是多少」,才談得上異常
偵測異常的前提,是知道正常長什麼樣子。最簡單的預期值是固定門檻,但現實中壓力會隨運轉條件變化:泵浦轉速上升,出口壓力隨之變化;流量增加,過濾器壓差也會增加。固定門檻要不就過嚴造成誤報,要不就過鬆漏掉真正的異常。
以過濾器壓差為例,在紊流條件下,壓差大致與流量的平方成正比。要判斷濾網是否變髒,必須先把流量的影響扣掉,換算成「參考流量下的壓差」,才能公平比較不同時間的數據:
ΔP_norm = ΔP_measured × ( Q_ref / Q_measured )²

例:參考流量 Q_ref = 100 m³/h
    今日量測 ΔP = 0.48 bar,流量 Q = 90 m³/h
ΔP_norm = 0.48 × (100/90)² ≈ 0.593 bar若沒有流量量測,只能在相對穩定的運轉條件下比較,或使用泵浦轉速與其他壓力作為替代變數建立統計模型。這也說明了一個重要的整合觀念:孿生模型需要的不只是壓力,還有運轉條件,規劃儀表時要把流量、轉速、溫度一併納入考量。
5.4 趨勢外推:估算多久後會到達限值
濾網堵塞、結垢、泵浦磨耗都是漸進式劣化,壓力或壓差會緩慢單調地變化。對這類現象,最簡單也最實用的預測方法,是對正規化後的壓差做線性迴歸,外推何時會到達維護限值。
表 5-2:過濾器壓差趨勢外推範例(數字為示意)
| 項目 | 數值 | 說明 |
|---|---|---|
| 60 天前正規化壓差 | 0.35 bar | 剛更換濾網時的基準 |
| 目前正規化壓差 | 0.80 bar | 經流量正規化後 |
| 平均上升速率 | (0.80 − 0.35) ÷ 60 = 0.0075 bar/天 | 線性假設 |
| 維護限值 | 1.20 bar | 依濾網規格與系統允許壓損設定 |
| 預估到達限值天數 | (1.20 − 0.80) ÷ 0.0075 ≈ 53 天 | 建議在約 70% 的剩餘時間時開立維護工單 |
線性外推有明顯的限制:堵塞速度常常隨時間加速(越堵越快),所以應同時監控上升速率本身的變化,一旦發現斜率明顯變大,就要縮短預估時間。另外,預測應該附帶信賴區間,並在資料不足、品質不良比例偏高時,主動表示「無法預測」,而不是輸出一個看似精確的錯誤答案。
5.5 從規則到統計,再到機器學習
表 5-3:異常偵測方法的選擇
| 方法 | 做法 | 優點 | 限制 | 建議使用時機 |
|---|---|---|---|---|
| 固定門檻 | 高高、高、低、低低限值 | 簡單、可解釋、符合現場慣例 | 無法適應運轉條件變化 | 第一階段,所有點位都應設定 |
| 變化率 | 單位時間內壓力變化超過門檻 | 能抓到突發事件(洩漏、爆管、閥門誤動作) | 對緩慢劣化無感 | 搭配固定門檻使用 |
| 滾動統計 | 與過去 N 天同時段的平均與標準差比較(如 z 分數、EWMA) | 能適應日週期與季節 | 需要足夠歷史資料、需調參 | 累積一到三個月資料後 |
| 殘差分析 | 以運轉條件預測壓力,比對實測與預測的差 | 排除運轉條件影響,靈敏度高 | 需要可靠的運轉條件資料與模型驗證 | 具備流量、轉速等輔助量測後 |
| 機器學習 | 非監督式異常偵測或預測性模型 | 能處理多變數複雜關係 | 需要大量標註或乾淨資料,可解釋性較差,維護成本高 | 前述方法已穩定運作,仍有明確缺口時 |
經驗法則:先把固定門檻與變化率做好,兩者已經能涵蓋大多數公用系統的重大異常。在沒有足夠乾淨資料、沒有可信的運轉條件量測之前,直接跳到機器學習,往往只是把資料品質問題包裝成演算法問題。
5.6 泵浦與管路:用壓力推算水頭與效率線索
在水系統中,壓力可以換算成水頭(以水柱高度表示),用來與泵浦特性曲線比對。對於水,1 bar 約等於 10.2 公尺水柱:
H(公尺水柱)= ΔP / (ρ × g)

水(ρ ≈ 1000 kg/m³,g ≈ 9.81 m/s²):
1 bar = 100,000 Pa → H ≈ 100,000 / (1000 × 9.81) ≈ 10.2 m泵浦出口壓力減去入口壓力,得到泵浦實際提供的揚程。若在相同轉速與流量下,揚程相比過去明顯下降,可能代表葉輪磨耗、內部洩漏或入口吸入條件不佳。入口壓力過低則要留意空蝕(Cavitation)風險,需要核對有效吸入水頭是否大於泵浦所需。這些判斷都只需要最基本的進出口壓力量測,卻能提供很高的診斷價值,這也是為什麼泵浦進出口永遠是壓力量測的優先點位。
5.7 孿生所需點位:用途決定量測
表 5-4:常見孿生應用與所需量測點
| 孿生應用 | 必要量測 | 建議輔助量測 | 主要輸出 |
|---|---|---|---|
| 泵浦健康 | 入口壓力、出口壓力 | 電流或功率、轉速、流量 | 揚程趨勢、空蝕風險、劣化提示 |
| 過濾器壽命 | 濾網前後壓力 | 流量、溫度(黏度影響) | 正規化壓差、剩餘天數估算 |
| 管網洩漏偵測 | 多個節點壓力 | 流量、閥門開度 | 壓力下降事件定位、疑似洩漏區段 |
| 壓縮空氣系統 | 空壓機出口、主管、末端壓力 | 流量、露點、電力 | 壓降分析、供氣穩定度、節能機會 |
| 潔淨室壓差 | 各區與走廊的差壓 | 溫濕度、風量 | 壓差級聯狀態、濾網負荷、門開啟事件影響 |
| 水箱與儲槽 | 液位(靜壓式) | 進出流量 | 庫存估算、補水預測 |
5.8 孿生的呈現:給人看的與給機器用的
孿生的呈現不需要華麗的 3D。工程師真正需要的,是能快速理解的資產狀態圖:用系統流程圖呈現上下游關係,每個節點用顏色表示健康狀態,點擊進入該資產的趨勢、告警與校正資訊。3D 模型在大型設施的導覽、空間定位與簡報展示上有價值,但不應先於資料品質與分析邏輯投入。同時,同一份資產狀態資料也應以機器可讀的 API 形式提供,讓維護管理系統(CMMS)、能源管理系統與報表系統能自動取用,避免資訊孤島。
最後要提醒的是,孿生模型本身也是需要維護的資產。儀表更換、管路改造、泵浦汰換,都必須同步更新資產關係與參數,否則模型會悄悄地與現場脫節。建議把「模型更新」納入工程變更管理流程,任何現場變更單都必須包含對孿生資料的檢視項目。
第 6 章:昶特 ATLANTIS 產品與三層導入配置
前五章討論的是資料鏈的設計。回到儀表層,昶特 ATLANTIS 擁有 31 年的壓力錶、溫度計與相關儀表製造經驗,產品線涵蓋機械式與數位式壓力錶、壓力開關、壓力傳送器、差壓、液位與溫度儀表。下面整理與 IT/OT 整合最相關的幾個系列,並說明如何依資料鏈需求搭配。再次強調:以下內容用於選型參考,實際的量程、精度、輸出選項、防護等級與防爆認證,請以最新規格書與報價內容為準,昶特產品採報價制。
責任界線再確認:昶特提供儀表與標準輸出介面,不提供雲端平台、AWS 或其他資料庫整合服務。客戶需自行(或委託系統整合商)把儀表輸出接入自己的邊緣設備、資料庫與應用系統。我們樂於在選型階段提供輸出介面、量程與環境適用性的建議,讓您的整合團隊有明確的規格可以依循。
6.1 產品介紹與整合角色
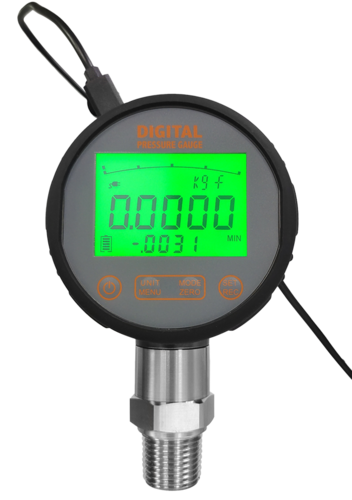
圖 6-1:ATLANTIS DPG-X112 高精度藍芽數位壓力錶——現場讀值與巡檢設定,並可依訂購規格搭配類比輸出
DPG-X112 高精度藍芽數位壓力錶的特色是現場大螢幕顯示與藍芽功能,適合需要巡檢人員在現場用手機讀值與設定的場合。依官網產品目錄,本系列提供 4–20mA/0–10V 輸出選項並可選配 HART 通訊(實際可選配置以規格書與報價為準)。在資料鏈中,它可以同時扮演兩個角色:現場可視化的儀表,以及透過類比輸出進入 PLC 或遠端 I/O 的資料源。
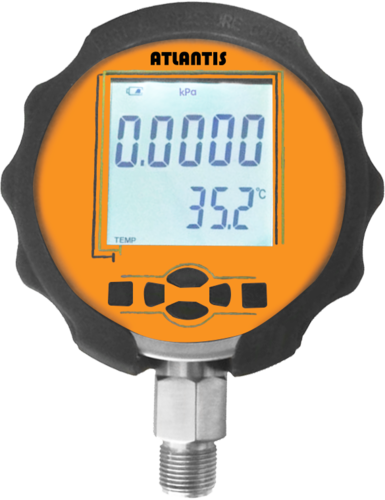
圖 6-2:ATLANTIS DPG-X002 高精度數位壓力錶——高精度顯示,支援 4–20mA 與 485 通訊選項
DPG-X002 高精度數位壓力錶在產品目錄中標示支援 4–20mA 與 485 通訊,具備數據記錄功能,適合需要較高精度、並希望以 RS485 掛載多台的製程壓力監測與能效管理點位。若您的資料庫設計需要讀取診斷資訊,建議在選型時一併向我們索取暫存器對照表。
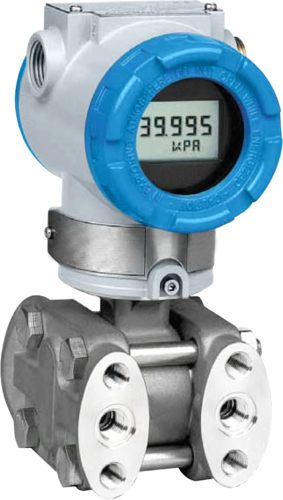
圖 6-3:ATLANTIS SDPT-3100 HART 智能型壓力傳送器——4–20mA/0–10V 輸出與 HART 通訊,適合遠端診斷
SDPT-3100 HART 智能型壓力傳送器在目錄中標示 4–20mA/0–10V 雙輸出、支援 HART 通訊與遠端診斷,防護等級為 IP67,可直接安裝於管線。對於已經有 4–20mA 迴路的既有系統,HART 能在不改線的前提下,取得設備組態與診斷資訊,是 IT/OT 整合中「增值而不大改」的選項。
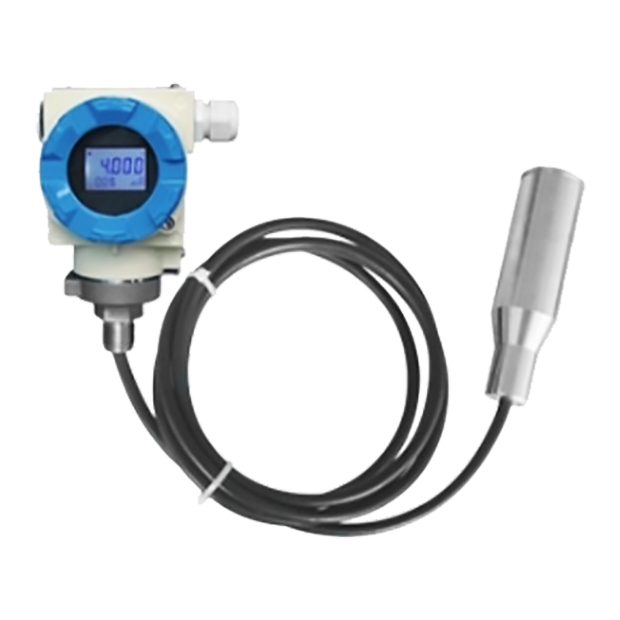
圖 6-4:ATLANTIS SLPTX 數位式 HART 智能型液位傳送器——靜壓式液位量測,適合儲槽與水池
SLPTX 數位式 HART 智能型液位傳送器採用靜壓式液位量測原理,輸出 4–20mA/0–10V,防護達 IP68 可浸沒使用。液位資料與壓力資料同屬靜壓量測的延伸,進入同一套資料表與 API 的成本幾乎為零,非常適合在試點成功後把儲槽與水池納入同一套孿生模型。
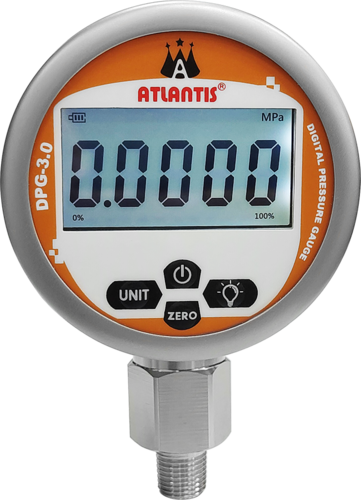
圖 6-5:ATLANTIS DPG-X3.0 系列——微差壓與過濾器壓差監測方向,現場可視化
DPG-X3.0 系列在產品目錄中定位於微小差壓的量測,應用方向包括無塵室壓差與過濾器壓差監測。前面第 5 章的「過濾器壽命」孿生應用,正是以這類差壓量測作為核心輸入。如需把讀值接入資料庫,請於選型時確認該型號是否提供您需要的輸出方式。
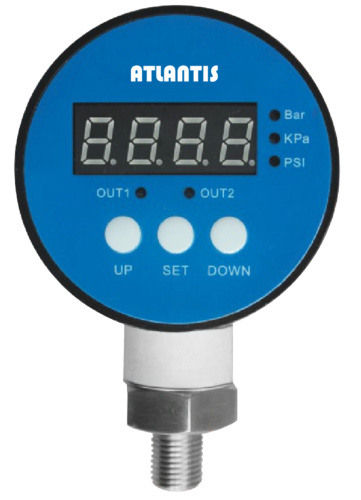
圖 6-6:ATLANTIS DPS-ED3.0 數位壓力開關——設定點與連鎖保護,補足資料鏈的本地安全動作
DPS-ED3.0 數位壓力開關用於泵浦保護、低壓與高壓連鎖等「需要在本地立即動作」的場合。這裡有一個重要的設計觀念:安全連鎖不應依賴資料庫與網路。資料鏈(儀表到 API)是用來監看與分析,真正攸關設備與人員安全的保護動作,應由本地的壓力開關、PLC 或安全控制器獨立完成,網路斷線不能影響保護功能。
6.2 產品與資料鏈角色對照
表 6-1:ATLANTIS 產品與 IT/OT 整合角色對照(輸出選項以規格書為準)
| 產品系列 | 量測類型 | 目錄所列輸出或通訊 | 在資料鏈中的角色 |
|---|---|---|---|
| DPG-X112 | 壓力(數位壓力錶) | 藍芽;4–20mA/0–10V,可選 HART | 現場可視化加類比資料源 |
| DPG-X002 | 壓力(高精度數位壓力錶) | 4–20mA/485 通訊 | 高精度製程點位、RS485 多點 |
| SDPT-3100 | 壓力或差壓傳送器 | 4–20mA/0–10V、HART | 關鍵點位、遠端診斷 |
| SLPTX | 液位(靜壓式) | 4–20mA/0–10V | 儲槽與水池資料源 |
| DPG-X3.0 系列 | 微差壓、壓差 | 依型號而定,請洽詢確認 | 過濾器與潔淨室壓差 |
| DPS-ED3.0 | 壓力開關 | 開關接點、設定值 | 本地保護連鎖,不依賴網路 |
更多型號可參考昶特工業儀表完整產品目錄,也可以使用壓力錶選型精靈快速縮小範圍;若想比較數位壓力錶的精度、量程、解析度與輸出差異,請見數位壓力錶選型對照表。
6.3 三層導入配置
不同規模與成熟度的工廠,適合不同的導入深度。以下三層配置是從實務經驗整理出來的建議,您可以從基礎層開始,逐步升級。
表 6-2:基礎、進階、企業三層導入配置
| 項目 | 基礎層 | 進階層 | 企業層 |
|---|---|---|---|
| 目標 | 讀值上線、基本趨勢與告警 | 診斷、衍生量、資產狀態 | 孿生推演、跨系統整合、全廠複製 |
| 點位規模 | 10–30 點 | 30–200 點 | 200 點以上 |
| 儀表配置 | 數位壓力錶加 4–20mA 輸出,關鍵點加壓力開關 | 加入 RS485 或 HART 傳送器,補充流量、溫度、液位 | 完整點位矩陣,關鍵設備冗餘量測 |
| 邊緣層 | 單一閘道器,唯讀採集 | 多閘道器,本地緩衝與事件觸發取樣 | 高可用閘道器,邊緣端預處理 |
| 資料層 | 單台 MySQL,讀值表分區 | MySQL 主從、分鐘彙總、tag_latest | MySQL 加時序資料庫,分層保存策略 |
| API 層 | 基本讀寫端點 | 資產狀態、告警管理、權限分級 | 完整 OpenAPI、事件推送、與 CMMS 與能源系統整合 |
| 孿生層 | 階段 1 至 2:資產階層與即時狀態 | 階段 3:預期值、趨勢外推、健康指標 | 階段 3 至 4:假設分析與最佳化建議(唯讀) |
| 建議時程 | 4–8 週 | 3–6 個月 | 6–18 個月,分階段 |
6.4 選型時要先問的八個問題
- 這個點位的資料要進資料庫嗎?還是只需要現場讀值?
- 現場已有 PLC 或遠端 I/O 嗎?它的類比輸入解析度夠嗎?
- 點位密集嗎?是否適合用 RS485 一條匯流排掛多台?
- 是否需要讀取儀表診斷資訊(HART 或 RS485 暫存器)?
- 量程是否涵蓋正常運轉與最大過載?正常壓力是否落在量程的 30%–70% 之間?
- 介質、溫度、震動與防護等級(粉塵、潮濕、沖洗)有什麼要求?
- 是否位於防爆區域,需要特殊認證?
- 校正週期與追溯要求為何?校正資料是否要匯入資料庫?
量程選擇尤其值得多花時間。量程過大,正常運轉落在量程前段,解析度與相對精度都會變差;量程過小,一旦過載就可能損壞感測元件。一般建議正常工作壓力落在量程的三分之一到三分之二之間,並確認最大瞬間壓力不超過過載耐壓。
第 7 章:情境推演與效益評估方法
B2B 的導入決策最終都要回答一個問題:投入值不值得?本章提供一套不依賴單價、可由您自行代入數字的效益評估框架,並以三個推演情境說明資料鏈在不同場景下能帶來哪些改變。
重要聲明:本章的三個情境是依常見工廠狀況設計的推演範例,用來示範評估方法,不是特定客戶的實際導入成果。其中的數字皆為假設值,請以您自己的現場數據替換。昶特產品採報價制,本章不涉及任何金額,效益以工時、次數與比例表達。
7.1 效益的五個來源
表 7-1:資料鏈導入的效益類型與衡量方式
| 效益類型 | 怎麼發生 | 衡量指標 | 資料來源 |
|---|---|---|---|
| 巡檢工時節省 | 自動採集取代人工抄表,保留抽查 | 每年節省工時 | 點檢表、排班紀錄 |
| 非計畫停機減少 | 提前偵測劣化與異常 | 停機次數與總時數 | 設備停機紀錄 |
| 能源與耗材節省 | 發現壓力設定過高、洩漏、過度更換 | 耗電、補水量、耗材更換次數 | 能源系統、採購紀錄 |
| 品質損失減少 | 壓力或壓差異常即時示警,避免批次受影響 | 報廢或重工比例 | 品質系統 |
| 稽核與追溯效率 | 電子化資料、校正紀錄集中管理 | 稽核準備工時、缺失項目數 | 稽核報告 |
7.2 評估公式
年度總效益 = 工時節省 + 停機損失減少 + 能源耗材節省 + 品質損失減少 + 稽核效率
年度總成本 = 儀表與周邊設備攤提 + 系統建置與維運 + 校正與維護
投資回收期(月)= 初期投入 ÷ (年度總效益 − 年度總成本)× 12
投資報酬率 = (年度總效益 − 年度總成本)÷ 初期投入評估時有一個常見的偏誤:把所有效益都歸功於新系統。比較誠實的做法是只計入可以明確歸因的效益,並對不確定性高的項目(例如避免的停機)採保守估計,同時列出「悲觀、基準、樂觀」三種情境,讓決策者看到風險範圍。
7.2.1 工時節省的算法示範
工時節省是最容易量化、最少爭議的效益,建議作為評估的基礎。假設某廠區有 40 個機械壓力錶需要每日巡檢:
表 7-2:巡檢工時節省計算範例(假設值)
| 項目 | 假設 | 計算 |
|---|---|---|
| 每日巡檢班次 | 3 班 | — |
| 每點讀值與記錄時間 | 1.5 分鐘(含走動) | 40 點 × 1.5 分鐘 = 60 分鐘/班 |
| 每日巡檢總時間 | — | 3 班 × 60 分鐘 = 180 分鐘 = 3 小時 |
| 每年巡檢總時數 | 365 天 | 3 × 365 = 1,095 小時 |
| 導入後保留抽查比例 | 20% | — |
| 每年節省工時 | — | 1,095 × (1 − 0.2) = 876 小時 |
這 876 小時並不代表人力裁減,而是巡檢人員可以轉去做更有價值的事:處理告警、做預防保養、執行校正。把「節省的時間」轉化為「更高價值的工作」,才是這類導入真正的效益所在。
7.3 情境一:冷卻水迴路的壓力與壓差監測(推演)
情境背景:一個中型廠區的冷卻水系統,包含兩台並聯泵浦、一組過濾器、主管與六條支管,目前以機械壓力錶人工巡檢,每班記錄一次。
常見痛點:泵浦切換時的壓力瞬降不被記錄;過濾器壓差只在每週保養時才看;支管流量不均導致部分負載偏熱,但無法判斷源頭。
建議的資料鏈範圍:泵浦進出口各一點、過濾器前後各一點、主管一點、六條支管末端各一點,共約 15 點,取樣 30 秒,事件觸發時 1 秒。孿生層建立「泵浦到過濾器到主管到支管」的資產關係。
表 7-3:情境一的推演目標與可驗證指標(目標值為假設,需以現場基線驗證)
| 指標 | 導入前(基線,需實測) | 導入後的推演目標 | 驗證方式 |
|---|---|---|---|
| 泵浦切換壓力瞬降的記錄率 | 幾乎無記錄 | 100% 可追溯事件 | 檢視事件觸發資料 |
| 過濾器更換時機判斷 | 依固定週期 | 依正規化壓差趨勢,提前約 2–3 週預警 | 比對預測與實際更換時點 |
| 支管壓力失衡的定位時間 | 數小時,需人員現場排查 | 縮短到數十分鐘內可指向疑似區段 | 統計歷次事件處理時間 |
| 巡檢工時 | 以表 7-2 方法實測 | 降低約 70–80%(保留抽查) | 排班紀錄比較 |
7.4 情境二:壓縮空氣系統的壓降與穩定度(推演)
情境背景:廠內壓縮空氣由多台空壓機供應,主管延伸到各產線,末端壓力不足時,產線氣動設備動作變慢或停頓。
常見痛點:空壓機出口壓力設定偏高以「保險」,造成耗能;各產線末端的壓降無人掌握;洩漏長期存在卻難以量化。
建議的資料鏈範圍:空壓機出口、儲氣槽、主管幹線數處、各產線入口末端,共約 12–20 點。這個情境的關鍵洞察是:壓力設定每降低一些,壓縮機耗能就會相應下降,但前提是末端壓力仍然穩定在需求之上。只有同時看見出口與末端壓力的長期資料,才敢放心調整設定值。
- 用壓降資料找出「主管瓶頸」:出口與末端壓差過大的區段,通常有管徑不足、過濾器堵塞或洩漏。
- 用夜間與假日的壓力下降速率估算洩漏:無生產期間壓力仍持續下降,代表系統存在洩漏。
- 用事件資料連結產線動作與壓力波動,找出突發大量用氣的設備。
7.5 情境三:潔淨室過濾器壓差與孿生預測(推演)
情境背景:潔淨室的風機過濾單元與高效率過濾器,需要維持房間與走廊之間的壓差級聯,濾網堵塞會影響風量與壓差。
建議的資料鏈範圍:各區與走廊的微差壓量測、主要過濾器前後差壓、搭配溫濕度,約 20–40 點。孿生層採用第 5 章的正規化壓差與趨勢外推,對每一組過濾器估算剩餘壽命,並把更換排程與生產排程整合,避免在關鍵批次期間被迫停機更換。
此情境對資料品質與稽核追溯的要求特別高:壓差紀錄常屬於品質文件,需要時間戳記可靠、資料不可竄改、告警與確認動作都有紀錄。因此 API 層的稽核紀錄與資料庫的備份策略,在這個情境下是必要條件而非加分項。
7.6 敏感度分析:哪些假設最影響結果
表 7-4:效益評估的敏感度檢視
| 假設 | 影響程度 | 建議處理 |
|---|---|---|
| 非計畫停機減少次數 | 高 | 以歷史停機紀錄為基準,採保守估計,不重複計入多重原因 |
| 巡檢保留比例 | 中 | 依品質與法規要求設定,不要假設完全取消人工 |
| 資料可用率 | 高 | 以試點期間實測的資料完整率為準 |
| 告警誤報率 | 高 | 誤報過高會讓整套系統失去信任,需預留告警調校時間 |
| 系統維運人力 | 中至高 | 明確指定維運責任人,納入成本 |
三個反思問題可以幫助您檢視評估是否紮實:第一,這項效益是否有可驗證的基線數據?第二,如果效益只達預期的一半,專案還值得做嗎?第三,誰負責在導入後持續追蹤這些指標?如果三個問題都答得出來,這份評估才經得起管理層的檢視。
第 8 章:資安、導入時程與驗收清單
IT/OT 整合最大的風險不在技術,而在「把原本隔離的控制網路接上了外部世界」。一次疏忽的設定,可能讓資料庫的漏洞變成產線停擺的入口。本章整理資安設計原則、分階段導入時程、驗收清單與常見故障排查表,協助您把專案做得穩。
8.1 資安設計原則
表 8-1:IT/OT 整合的資安控制措施
| 面向 | 建議措施 | 為什麼 |
|---|---|---|
| 網路分區 | 依 IEC 62443 的區域與管道觀念,把儀表與控制網路、邊緣層、企業網路分開,區域之間只開放必要的連線 | 限制單一入侵點的擴散範圍 |
| 資料方向 | 採集一律唯讀;資料由內往外送,不開放外部連入控制網路 | 避免外部攻擊者透過資料鏈操作現場設備 |
| DMZ | 在控制網路與企業網路之間設置緩衝區,接收服務放在 DMZ | 讓高風險的對外服務與控制網路隔離 |
| 身分與憑證 | 閘道器使用專屬金鑰或憑證,可獨立撤銷;人員使用企業身分提供者與多因素驗證 | 降低憑證外洩的影響範圍 |
| 傳輸加密 | 全程 TLS,MQTT 啟用 TLS 與帳號權限控制 | 防止竊聽與竄改 |
| 密鑰管理 | 不將密碼與金鑰寫入程式碼或設定檔,使用密鑰管理服務或環境保護機制 | 避免程式碼外流造成金鑰洩漏 |
| 修補與漏洞管理 | 資料庫、作業系統、閘道器韌體定期更新,更新前先在測試環境驗證 | 工業環境的更新需謹慎,但不可長期不更新 |
| 稽核與監控 | 集中收集存取日誌與變更紀錄,對異常登入與異常流量告警 | 事後調查與即時偵測 |
| 備份與還原 | 定期備份並實際演練還原 | 勒索軟體與誤操作的最後防線 |
| 實體安全 | 閘道器與交換器置於上鎖機櫃,停用未使用的埠 | 防止現場直接接入 |
藍芽與無線的提醒:藍芽功能很方便,但會增加現場無線攻擊面。若儀表具備藍芽,建議在不需要時關閉,或啟用配對保護,並在資安政策中明確規範誰可以在現場連線與修改設定。
8.2 責任矩陣:誰負責什麼
專案失敗常常卡在「這件事到底誰管」。建議在專案啟動時就用責任矩陣把各項工作的負責人講清楚:
表 8-2:IT/OT 整合專案責任矩陣(範例)
| 工作項目 | 儀表供應商(昶特) | OT/廠務 | IT/資料團隊 | 系統整合商 |
|---|---|---|---|---|
| 儀表選型建議與規格提供 | 主責 | 協作 | — | 協作 |
| 現場安裝、接線、迴路測試 | 技術諮詢 | 主責 | — | 協作 |
| 儀表校正與維護 | 提供校正資訊與建議週期 | 主責 | — | — |
| 邊緣層採集與換算 | 提供通訊規格 | 協作 | 協作 | 主責 |
| 資料庫與 API 建置 | — | 需求提出 | 主責 | 協作 |
| 告警規則與門檻設定 | 提供量測與規格建議 | 主責 | 協作 | 協作 |
| 資安政策與審查 | — | 協作 | 主責 | 協作 |
| 孿生模型建置與維護 | — | 提供製程知識 | 主責 | 協作 |
8.3 分階段導入時程
表 8-3:試點專案八週時程範例
| 週次 | 工作內容 | 產出 |
|---|---|---|
| 第 1 週 | 確認目標系統、痛點與成功標準;現場勘查;盤點既有 PLC、I/O 與網路 | 需求說明、點位初稿 |
| 第 2 週 | 儀表選型與規格確認、通訊規格卡、點位命名規則定案 | 點位清單、規格卡、命名規範 |
| 第 3–4 週 | 儀表安裝、接線、迴路測試;邊緣閘道器佈建;資料庫與 API 開發 | 迴路測試紀錄、測試環境上線 |
| 第 5 週 | 端到端測試:以標準器比對現場讀值與資料庫讀值 | 比對報告、偏差分析 |
| 第 6 週 | 告警門檻初調、儀表板與資產狀態頁建立 | 第一版儀表板、告警規則 |
| 第 7 週 | 平行運行:自動資料與人工抄表並行,統計差異與資料完整率 | 資料品質報告 |
| 第 8 週 | 驗收、教育訓練、維運交接、規劃下一階段 | 驗收報告、維運手冊 |
8.4 驗收清單
- 每一個點位都有完整的主檔資料:點位名稱、資產關聯、儀表序號、量程、單位、校正日期。
- 端到端比對:同一時刻,現場標準器讀值、儀表顯示、資料庫讀值三者差異在規定誤差預算內。
- 斷線與故障測試:模擬 4–20mA 斷線、RS485 離線,確認品質代碼正確且不產生假壓力值。
- 網路中斷測試:拔掉對外連線一段時間,確認邊緣緩衝運作,恢復後補傳完整且順序正確、不覆蓋較新資料。
- 重複送資料測試:同一批資料送兩次,確認資料庫不重複、最新值表不被舊資料覆蓋。
- 權限測試:唯讀帳號無法寫入,閘道器金鑰無法查詢其他資料,撤銷金鑰立即生效。
- 時間同步:閘道器與伺服器的時間偏移在容許範圍內,並有監控。
- 備份與還原演練:實際從備份還原一次並驗證資料。
- 告警測試:每一類告警都實際觸發並確認通知、確認、關閉流程。
- 文件齊備:網路圖、資料流圖、API 文件、通訊規格卡、維運手冊、緊急聯絡人。
8.5 常見問題排查表
表 8-4:現場常見現象、可能原因與檢查方向
| 現象 | 可能原因 | 檢查方向 |
|---|---|---|
| 讀值與現場錶頭差一個固定偏差 | 零點偏移、取壓位置高度差、換算參數設定錯誤 | 確認量程設定、單位、取壓點高度;以標準器比對 |
| 讀值是離譜的大數字或負數 | 浮點數字組順序解析錯誤 | 核對暫存器對照表,嘗試切換字組順序 |
| 某幾台儀表偶爾通訊逾時 | 匯流排終端電阻缺失、屏蔽接地不良、位址衝突、鮑率設定不一致 | 檢查終端電阻、接地、位址表與通訊參數 |
| 讀值有規律的鋸齒或跳動 | 電氣干擾、變頻器雜訊、取壓管內有氣泡或脈動 | 檢查屏蔽與走線;現場確認取壓管排氣;評估阻尼或平均 |
| 數值長時間完全不變 | 邊緣程式卡住、儀表凍結、取壓孔堵塞 | 檢查疑似卡值告警;對照鄰近點位;現場檢查取壓管 |
| 資料庫出現未來時間的資料 | 閘道器時鐘錯誤 | 檢查 NTP 同步;啟用 API 的未來時間檢查 |
| 斷線重連後最新值變成舊資料 | 最新值表未判斷時間戳記先後 | 採用第 3.6 節的條件式更新 |
| 儀表板很慢 | 查詢直接掃描原始大表、缺少彙總、索引使用不當 | 改用彙總表與最新值表;檢查執行計畫 |
| 告警一直反覆開關 | 沒有延遲確認與遲滯 | 加入 on-delay 與 deadband |
8.6 持續維運:資料鏈不是裝好就結束
整合專案上線後,維運才真正開始。建議建立固定的檢視節奏:每日檢視各閘道器最後上線時間與資料完整率,每週檢視死信區與告警品質(誤報與漏報),每月檢視分區與容量、備份驗證,每季檢視校正到期清單與告警門檻是否仍合理,每年檢視資安政策、使用者權限與整體架構是否需要調整。校正管理尤其重要:儀表的精度會隨時間漂移,過期未校正的儀表所產生的資料,品質再高的資料鏈也無法彌補。
第 9 章:20 個常見問題 FAQ
以下整理工程師、IT 團隊與採購在規劃數位壓力錶、MySQL、API 與數位孿生整合時最常提出的問題。點擊問題即可展開答案。
❓ Q1: 數位壓力錶可以直接把資料寫進 MySQL 嗎?
不行,中間一定需要一層「邊緣」。儀表本身只輸出 4–20mA、0–10V、RS485 或 HART 這類現場訊號,不會自己連到資料庫。實務上由 PLC、遠端 I/O 或 Modbus 閘道器負責採集、換算工程單位、加上時間戳記與品質標記,再透過 MQTT 或 HTTPS 送到接收服務,最後寫入 MySQL。
這個邊緣層的好處是把現場可靠度與資料庫維運分開,資料庫維護或網路中斷時,邊緣端仍可本地緩衝,不會遺失資料。
❓ Q2: 昶特 ATLANTIS 有提供雲端、AWS 或資料庫整合服務嗎?
沒有。昶特提供的是現場儀表(數位壓力錶、壓力傳送器、液位與溫度儀表等)以及標準的輸出介面與規格資料。邊緣設備、資料庫、API、雲端平台與數位孿生,需由客戶自己的 IT 團隊或系統整合商建置。
我們可以在選型階段協助您確認輸出介面、量程、環境適用性,並提供通訊規格資料,讓整合團隊有明確依據。
❓ Q3: 4–20mA、RS485 Modbus 與 HART,應該怎麼選?
沒有絕對的好壞,取決於現場條件。
- 已有 PLC 或 DCS、點位分散:4–20mA 最通用,抗干擾佳,可偵測斷線。
- 點位密集、希望減少佈線、需要讀取診斷資料:RS485 Modbus 一條匯流排可掛多台。
- 已有 4–20mA 迴路、想在不改線下取得設備診斷與遠端組態:HART。
- 兩種並用也很常見:4–20mA 供控制系統使用,另以數位通訊讀取診斷與組態。
❓ Q4: 藍芽數位壓力錶可以當作資料庫的主要資料來源嗎?
不建議。藍芽適合巡檢人員用手機在現場讀值、設定與抽查,但距離、穩定性與連續性都不適合作為全廠資料主幹,也會增加無線攻擊面。要進入資料庫的點位,應以 4–20mA、RS485 或 HART 等有線介面為主,藍芽作為現場輔助功能。
❓ Q5: 壓力資料的取樣週期要設多快?
依現象的變化速度而定。冷卻水、空調、壓縮空氣等公用系統的壓力變化多為分鐘等級,30 至 60 秒取樣已足夠。泵浦起停、水錘、液壓脈動等快速事件,則需要秒級甚至更快的取樣。
- 平時以 30–60 秒記錄趨勢。
- 壓力變化率超過門檻或越過告警線時,自動切換為 1 秒記錄並保留前後緩衝。
- 事件結束後降回低頻,避免資料量無謂膨脹。
❓ Q6: MySQL 撐得住工業壓力資料嗎?
在合理的規模下可以。點位數百到數千、取樣週期 10 秒以上時,MySQL 8 搭配依時間分區的讀值表、批次寫入、最新值表與分鐘彙總表,通常足以應付。
若點位數達數千以上且需高頻取樣與大量長期時序分析,可考慮把歷史讀值搬到時序資料庫,MySQL 保留資產、校正與告警等關聯資料。因為有 API 層隔離,這種搬遷不需要改動應用端。
❓ Q7: 為什麼要多一層 API,而不是讓儀表板直接連資料庫?
直接連資料庫短期省事,長期會造成權限難以控管、不同工具的查詢互相拖累、資料表結構一改所有下游都壞。API 層提供一份穩定的契約:可以做驗證與授權、限制單次查詢範圍保護資料庫、依區間自動選擇原始或彙總資料、留下稽核紀錄,資料庫內部也能自由演進。
❓ Q8: 網路重送或補傳資料時,如何避免資料重複?
以資料庫主鍵與請求冪等設計處理。讀值表的主鍵採用(點位、測量時間),同一筆資料重送時,用 ON DUPLICATE KEY UPDATE 覆寫而不會新增重複列。寫入端點另可支援 Idempotency-Key,相同請求只處理一次。
最新值表則需要加上時間戳記先後判斷,避免補傳的舊資料覆蓋較新的最新值。
❓ Q9: 網路或資料庫中斷時,資料會不會遺失?
只要邊緣端設計了本地緩衝就不會。邊緣閘道器應把待送資料暫存於本地儲存,連線恢復後依序補傳,並以指數退避避免瞬間灌爆接收服務。需要事先評估緩衝容量,確認能撐過預期的最長中斷時間,並在驗收時實際拔線測試。
❓ Q10: 如何分辨是儀表壞了,還是壓力真的很低?
4–20mA 的活零點設計正是為此而生。壓力為零時電流是 4 mA,不是 0 mA;若量到低於約 3.6 mA 或高於約 21 mA,依 NAMUR NE43 的建議通常視為迴路故障(斷線、短路、感測器失效)。
邊緣端應先判斷電流是否在合理範圍,超出時把資料標記為 BAD_SENSOR,而不是直接換算成一個看似正常的壓力值。數位通訊的儀表也可讀取自身診斷旗標。
❓ Q11: 校正週期與資料庫有什麼關係?
校正狀態是資料品質的一部分。建議在資料庫建立校正紀錄表,記錄校正日期、偏差、證書編號與下次到期日,並讓 API 的資產狀態端點一併回傳校正是否逾期。逾期儀表所產生的資料可以被標記,分析與稽核時就能判斷該採信多少。校正週期本身則依儀表精度等級、使用環境與品質系統要求決定。
❓ Q12: 數位孿生一定要有 3D 畫面嗎?
不需要。對工程師而言,孿生的價值在於能比對預期值、判斷趨勢與推演情境,而不在於畫面是否華麗。用系統流程圖呈現上下游關係、以顏色標示健康狀態,已能滿足大多數維運需求。3D 在大型設施導覽與簡報上有價值,但應在資料品質與分析邏輯穩定之後再投入。
❓ Q13: 數位孿生可以直接回寫、控制現場設備嗎?
技術上可行,但不建議作為第一批專案目標。回寫控制牽涉製程安全、功能安全評估與責任界定。比較穩健的做法是先建立唯讀的孿生:模型從現場取資料、產生診斷與建議,由人決定是否採取行動。待資料與模型長期驗證可靠,再依風險評估逐步考慮有限度的自動化。
❓ Q14: 預測性維護需要累積多少資料才有意義?
視方法而定。固定門檻與變化率告警不需要歷史資料,上線即可使用。滾動統計與殘差分析,通常需要至少數週到數個月涵蓋不同運轉條件與季節的乾淨資料。機器學習方法需要的資料量與資料品質要求更高。
對漸進式劣化(濾網堵塞、結垢),只要有穩定的正規化壓差資料,數週的趨勢就足以做線性外推的初步預估,並隨資料累積持續修正。
❓ Q15: 壓力量測點位(Tag)要怎麼命名?
建議採用固定層級、句點分隔的命名,例如「廠區.系統.設備.量測意義」:FAB1.CW.PUMP01.DISCH_P。命名規則在專案初期就要定案並文件化,並規範縮寫、大小寫與單位表示方式。同時把點位與資產、儀表分成不同資料表,儀表更換時點位與歷史資料才不會中斷。
❓ Q16: 安全連鎖可以仰賴這套資料庫與 API 系統嗎?
不可以。資料鏈用於監看、分析與預警,不是安全保護系統。攸關人員與設備安全的連鎖動作,必須由本地的壓力開關、PLC 或安全控制器獨立完成,網路中斷、資料庫維護或軟體故障都不能影響保護功能。資料鏈上看到的告警,是輔助而非取代本地保護。
❓ Q17: 時區與時間同步要怎麼處理?
全系統一律儲存 UTC 時間,僅在顯示層轉換為本地時區,避免日光節約時間與跨地區的混淆。邊緣端在採集當下打上時間戳記,而不是等入庫時才補。閘道器與伺服器都應同步到可靠的時間源,並監控時間偏移。資料表另可保留「測量時間」與「接收時間」兩個欄位,兩者差距本身就是一項有用的健康指標。
❓ Q18: 量程要怎麼選,才不會浪費解析度?
一般建議正常工作壓力落在量程的三分之一到三分之二之間,並確認最大瞬間壓力不超過儀表的過載耐壓。量程過大,正常值落在量程前段,解析度與相對精度都會變差;量程過小,過載時可能損壞感測元件。同時要讓類比輸入模組的解析度與儀表精度相匹配,避免整體精度被轉換環節拖累。
❓ Q19: 第一次導入,建議從哪裡開始、需要多久?
建議選一個有明確痛點的公用系統當試點,例如冷卻水迴路、壓縮空氣或過濾器壓差,規模 10 至 30 點,約四到八週完成選型、施工、資料驗證與告警調校。重點是打通「儀表到 API 到儀表板」的完整鏈路、驗證資料品質與團隊分工,再複製到下一個系統,而不是一開始就想接全廠。
❓ Q20: 要如何取得規格書與通訊資料,並進行詢價?
昶特產品採報價制,請告知量測介質、量程、所需輸出介面(4–20mA、RS485、HART 等)、安裝環境與數量,我們會協助確認適用型號並提供規格書與通訊資料。您可以使用官網的線上詢價表單,或直接聯絡業務一部 Ian、業務二部 Nori,聯絡方式請見本文結尾。
第 10 章:延伸閱讀與相關資源
想進一步了解儀表選型、讀值診斷與各類系統的壓力監測,可以從以下資源繼續閱讀:
- 昶特工業儀表完整產品目錄:查看數位壓力錶、壓力傳送器、差壓、液位與溫度儀表全系列。
- 壓力錶選型精靈:依介質、量程、安裝方式快速縮小型號範圍。
- 數位壓力錶選型對照表:精度、量程、解析度、輸出一次比較。
- 壓力錶與 PLC 讀值差異診斷完整指南:整合後讀值對不上時的排查方法。
- BMS 壓力監測完整選型指南:4–20mA 壓力變送器、壓力錶與差壓計的選型。
- 差壓突然升高代表什麼?工程判斷表:過濾器堵塞與泵浦異常的診斷。
- 天然氣設備壓力監測與供氣安全:燃氣系統的壓力監測思路。
- 熱電偶與 RTD 選型精靈:把溫度量測納入同一套資料鏈時的選型工具。
- 昶特 ATLANTIS 品牌故事:31 年儀表製造經驗與品牌理念。
結論:從一支儀表開始,建立可信的資料鏈
回顧整條資料鏈,數位壓力錶只是起點,真正決定成敗的是每一層的細節:儀表的量程與精度是否符合需求、訊號換算與品質標記是否嚴謹、資料表是否支援冪等與分區、API 是否提供穩定且安全的契約、孿生模型是否建立在可信的資料與合理的預期值之上。
我們建議的路徑是:選一個有明確痛點的系統做試點,用最小的範圍打通完整鏈路;先做好固定門檻與變化率告警,再逐步加入正規化壓差、趨勢外推與資產關係;永遠把安全連鎖留在本地,把資料鏈定位為監看與分析;並且清楚劃分各方責任,讓昶特專注在儀表端的可靠度,讓您的團隊掌握資料與應用端的自主性。
再次說明,昶特 ATLANTIS 不提供雲端或 AWS 整合服務,但我們樂意在儀表選型、輸出介面與通訊規格上,與您的 IT 與整合團隊一起把需求講清楚,讓整合專案有堅實的起點。
聯絡 ATLANTIS 昶特
想確認適合的數位壓力錶、壓力傳送器與輸出介面,歡迎提供量測介質、量程、安裝環境與數量,我們協助您選型並提供規格資料與報價。
- 業務一部 Ian|電話:02-2820-3405|信箱:ian@atlantis.com.tw
- 業務二部 Nori|電話:02-2820-3405|信箱:nori@atlantis.com.tw
- 昶特有限公司|台北市北投區致遠一路二段 109 號
- 傳真:02-2827-0646 / 02-2820-3406
- 公司官網:re-atlantis.tw
- 快速詢價:線上詢價表單